Dies ist eine alte Version des Dokuments!
LU08a - Warum mehrere Tabellen?
Lernziele
- Ich kann an einem Beispiel zeigen, welche Probleme entstehen, wenn alle Daten in einer einzigen Tabelle stehen (Redundanz und Inkonsistenz).
- Ich kann begründen, warum in einer Zelle nur ein Wert stehen soll.
Unser Beispiel: ein Reiseblog
Web-Apps wie WordPress verteilen ihre Inhalte auf mehrere Tabellen: Benutzer:innen, Beiträge, Kategorien, Kommentare. WordPress läuft wie unser Kurs auf MySQL oder auf MariaDB, einer eng verwandten Abspaltung davon.
Als Beispiel nehmen wir den Reiseblog WE TRAVEL THE WORLD von Caro und Martin. Er hat mehrere Autor:innen, viele Kategorien (Städtereise, Abenteuer, einzelne Länder) und Kommentare zu jedem Beitrag.
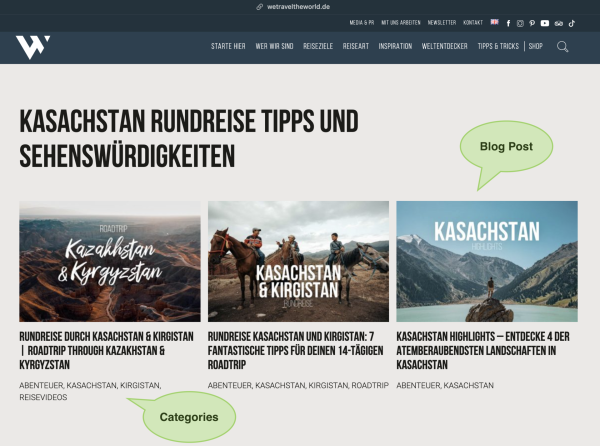 Startseite mit mehreren Blog-Posts und ihren Kategorien.
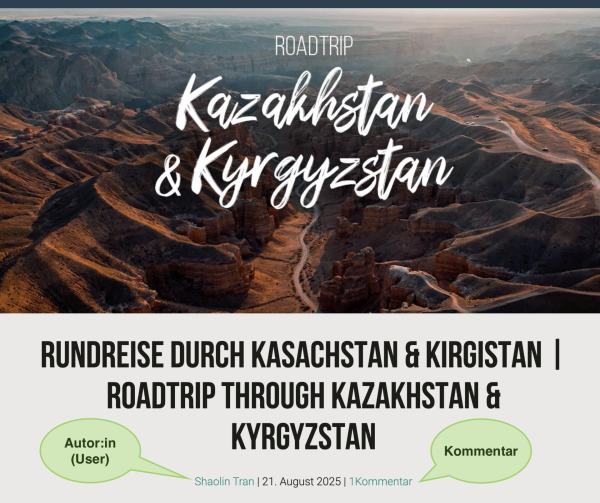 Einzelansicht mit Titel, Bild, Autor:in, Datum und Anzahl Kommentare.
Als ERD in Chen-Notation (wie in LU04) sieht das etwa so aus:
 Die Kommentare lassen wir hier weg, damit der Einstieg einfach bleibt.
Alles in einer Tabelle
Am einfachsten wäre es, alles in eine einzige Tabelle zu schreiben: Post, Autor und Kategorie zusammen.
CREATE TABLE blog_posts (
  id             INT AUTO_INCREMENT PRIMARY KEY,
  post_title     VARCHAR(200) NOT NULL,
  post_content   TEXT,
  author_name    VARCHAR(100) NOT NULL,
  author_email   VARCHAR(200) NOT NULL,
  category_name  VARCHAR(100) NOT NULL
);

INSERT INTO blog_posts (post_title, post_content, author_name, author_email, category_name)
VALUES
  ('Hasselt – 10 Highlights', 'Kurzguide …', 'Martin Merten', 'martin@wetraveltheworld.de', 'Städtereise'),
  ('Utrecht – 10 Sehenswürdigkeiten', 'Cafés, Grachten …', 'Martin Merten', 'martin@wetraveltheworld.de', 'Städtereise'),
  ('Lissabon – 8 Tipps', 'Aussichtspunkte …', 'Caro Steig', 'caro@wetraveltheworld.de', 'Portugal');

Das funktioniert. Mit der Zeit zeigen sich aber vier Probleme.
Problem 1: Dieselben Daten stehen mehrfach da
Name und E-Mail von Martin stehen bei jedem seiner Posts. Diese Wiederholung heisst Redundanz. Bei zwei Posts ist das kein Problem, bei 200 Posts schon.
Problem 2: Die Daten widersprechen sich
Martin hat eine neue E-Mail-Adresse. Wird sie nur in einer Zeile geändert, stehen plötzlich zwei verschiedene Adressen in der Datenbank.
UPDATE blog_posts
SET author_email = 'martin.new@wetraveltheworld.de'
WHERE id = 1;
| id | post_title | author_name | author_email |
|---|---|---|---|
| 1 | Hasselt – 10 Highlights | Martin Merten | martin.new@wetraveltheworld.de |
| 2 | Utrecht – 10 Sehenswürdigkeiten | Martin Merten | martin@wetraveltheworld.de |
Welche Adresse stimmt? Das kann die Datenbank nicht wissen. Solche widersprüchlichen Daten nennt man Inkonsistenz.
Problem 3: Tippfehler fallen nicht auf
Ein vertauschter Buchstabe reicht. Hier steht Stätdereise statt Städtereise:
INSERT INTO blog_posts (post_title, post_content, author_name, author_email, category_name)
VALUES ('Maastricht an einem Tag', 'Spaziergang …', 'Caro Steig', 'caro@wetraveltheworld.de', 'Stätdereise');
Die Datenbank speichert das ohne Fehlermeldung. Die Folgen sieht man erst später:
| Abfrage | Folge |
|---|---|
SELECT DISTINCT category_name FROM blog_posts; | Die Kategorienliste zeigt zwei Einträge: Städtereise und Stätdereise |
SELECT post_title FROM blog_posts WHERE category_name = 'Städtereise'; | Der Maastricht-Post fehlt im Ergebnis |
Das gleiche Problem haben wir in LU07 gesehen. In der Spalte Certificate von imdb_top_1000 stehen UA und U/A, zwei Schreibweisen für dieselbe Freigabe.
Problem 4: Nur eine Kategorie pro Post
Der Utrecht-Post gehört zu zwei Kategorien: Niederlande und Städtereise. Die Spalte category_name kann aber nur einen Wert aufnehmen.
Man könnte beides mit Komma in dieselbe Zelle schreiben (Niederlande, Städtereise). Das verstösst gegen eine Regel aus LU04: Eine Zelle, ein Wert. Was dann passiert:
- Die Datenbank kann nicht prüfen, ob die Kategorien überhaupt existieren. Tippfehler bleiben unbemerkt.
- Suchen mit LIKE werden ungenau. ''LIKE '%Guinea%' '' findet Guinea, Guinea-Bissau, Äquatorialguinea und Papua-Neuguinea, also vier verschiedene Länder.
- Wer zählen will, wie viele Posts es pro Kategorie gibt, muss jeden Text zuerst zerlegen.
Daten auf mehrere Tabellen verteilen
Für jede Entität gibt es eine eigene Tabelle: users, posts und categories. Jede Autorin steht dann genau einmal in der Datenbank. Ändert sich ihre E-Mail-Adresse, passiert das an einer einzigen Stelle.
Verbunden werden die Tabellen über Fremdschlüssel. Wo der Fremdschlüssel hinkommt, wissen wir aus LU04: auf die „viele“-Seite. Eine Autorin schreibt viele Posts. Deshalb bekommt posts eine Spalte author_id, die auf die Autorin verweist.
Beziehungen in relationalen Datenbanken (1:n, n:m, 1:1), einfach erklärt (9:02 min, deutsch). Quelle: Patrick Boekhoven / YouTube
Auf der nächsten Seite bauen wir diese Tabellen. Diesmal mit Fremdschlüsseln, die von der Datenbank auch geprüft werden.
 Guido Koch